


Deep learning: Ako funguje hlboké učenie, mýty a fakty

Deep learning (hlboké učenie) je technológia strojového učenia, ktorá spracúva dáta cez viacvrstvové neurónové siete a automaticky sa učí z veľkého množstva príkladov. Práve táto schopnosť rozpoznávať vzory bez explicitne naprogramovaných pravidiel stojí za väčšinou dnešných AI nástrojov, od chatbotov až po autonómne vozidlá.
V článku sa dozvieš:
Deep learning je čoraz častejšou témou, stále sa s ním však spája viacero mýtov. Napríklad, že je to to isté ako umelá inteligencia, že dokáže vyriešiť akýkoľvek problém alebo že je príliš drahý na bežné použitie. Dnes ti preto vysvetlíme, ako neurónové siete skutočne fungujú, v čom sa deep learning líši od klasického machine learningu a kde sa dnes reálne využíva.
Čo je deep learning a hlboké učenie?
Deep learning je podoblasť strojového učenia, ktorá využíva umelé neurónové siete s mnohými vrstvami na automatické extrahovanie vzorov z dát. Na rozdiel od klasických algoritmov mu nemusíš explicitne vysvetľovať, na čo sa má pri rozhodovaní zamerať. Vzory si nájde sám, priamo z trénovacích dát, bez ručne definovaných pravidiel či čŕt.
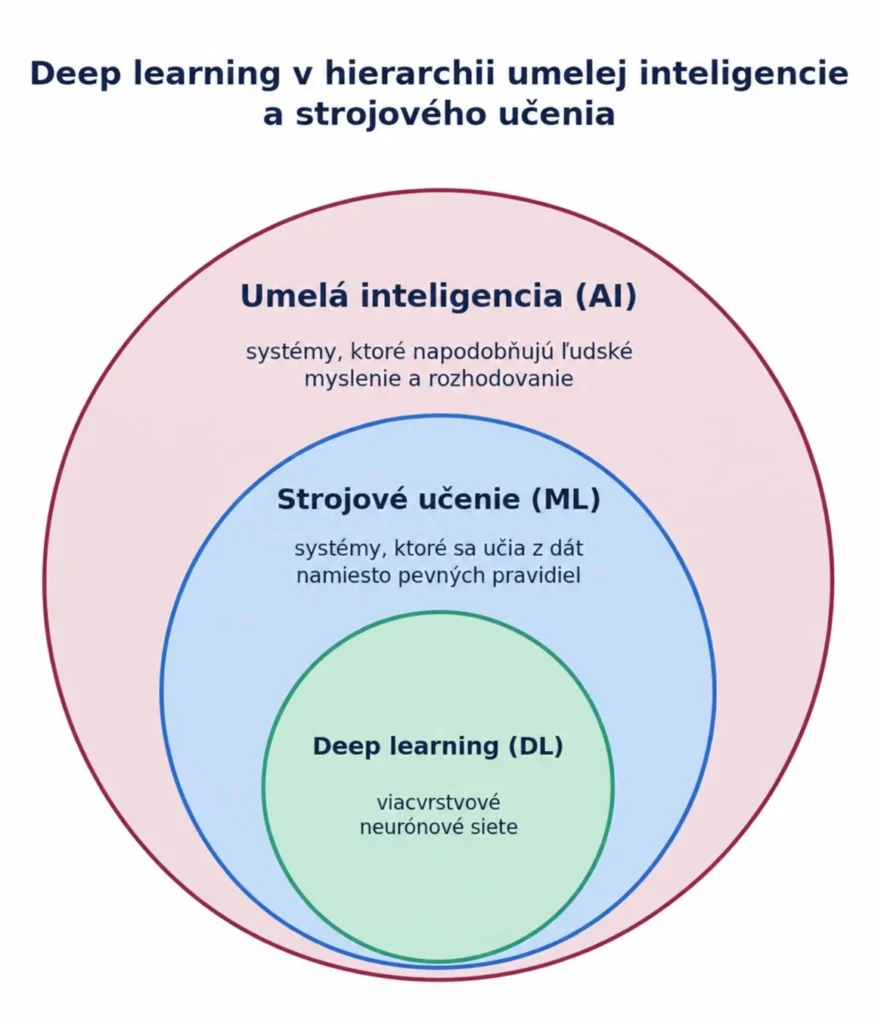
Aby ti bolo jasné, kam deep learning patrí, si predstav tri sústredené kruhy. Najväčší kruh je umelá inteligencia, celá oblasť, ktorá sa snaží napodobniť ľudské myslenie a rozhodovanie, vrátane jednoduchých pravidlových systémov. Vnútri neho je strojové učenie, teda podoblasť, v ktorej sa systémy učia z dát namiesto pevne naprogramovaných pravidiel. Úplne vo vnútri je deep learning, špecifický prístup k strojovému učeniu, ktorý stavia na viacvrstvových neurónových sieťach a dnes stojí za väčšinou najviditeľnejších AI aplikácií.
Koncept neurónových sietí existuje už desaťročia, prakticky využiteľným sa však deep learning stal až po roku 2010, a to kombináciou troch faktorov: dostupnosti obrovského množstva digitálnych dát, výkonných GPU pôvodne vyvinutých pre hry a pokroku v samotných architektúrach sietí. Práve táto kombinácia stojí za tým, že dnes deep learning bežne stretávaš v telefóne, aute aj v bankovej aplikácii, aj keď si to často ani neuvedomuješ.
Ako funguje deep learning v troch krokoch
Spôsob fungovania deep learningu sa dá zjednodušiť do troch krokov:
- Zhromaždenie dát: veľké množstvo príkladov, ako sú obrázky, texty, zvuk alebo tabuľkové dáta.
- Spracovanie dát: dáta postupne prechádzajú cez viaceré vrstvy neurónov, z ktorých každá extrahuje zložitejšie vzory.
- Výsledok: sieť vyprodukuje predikciu, klasifikáciu alebo rozhodnutie.
Príklad: Keď model rozpoznáva na fotke psa, prvé vrstvy si všímajú len hrany a kontrasty, stredné vrstvy z nich poskladajú tvary ako uši alebo labky a posledné vrstvy tieto tvary vyhodnotia ako celok a rozhodnú, že ide práve o psa. Rovnaký princíp funguje aj pri rozpoznávaní reči, textu alebo pri predikcii na základe tabuľkových dát. Mení sa len typ vstupu a architektúra siete.
Toto viacvrstvové spracovanie je aj dôvodom, prečo sa technológia volá hlboké učenie. Hĺbka pritom odkazuje na počet vrstiev v sieti, nie na kvalitu alebo zložitosť poznania. V textoch sa občas stretneš aj s variantom hĺbkové učenie, zaužívanejší je však termín hlboké učenie. Ako tieto vrstvy fungujú, rozoberá nasledujúca časť.
Ako funguje neurónová sieť: od neurónu k vrstvám
Ak chceš naozaj pochopiť, ako funguje deep learning a ako dokáže z obrovského množstva dát vyťažiť zmysluplné vzory, potrebuješ poznať základnú stavebnú jednotku neurónovej siete – umelý neurón – a spôsob, akým sa milióny takýchto neurónov zapájajú do vrstiev a učia sa spoločne.
Umelý neurón: vstupy, váhy, bias, aktivácia
Umelý neurón je matematická funkcia. Prijíma vstupy, každý z nich vynásobí váhou, pripočíta bias a výsledok pretransformuje aktivačnou funkciou na výstupný signál. Názov má podľa biologického neurónu v mozgu, ide však len o jeho zjednodušený matematický model. Jednotlivé časti neurónu ukazuje nasledujúca schéma.
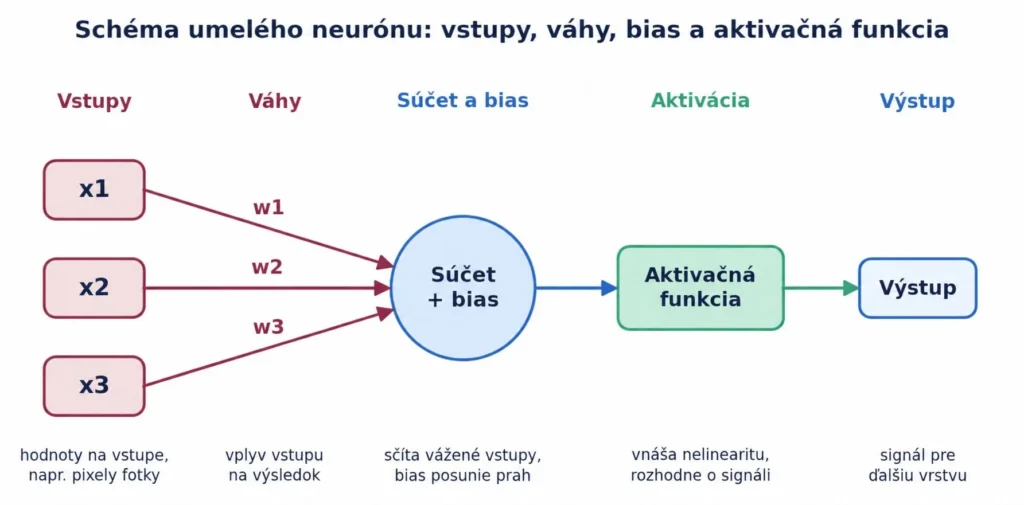
Príklad: Model má rozhodnúť, či je na fotke pes. Na vstupe má hodnoty jednotlivých pixelov fotky. Každý vstup má priradenú váhu, ktorá určuje, aký je relevantný pre finálne rozhodnutie. Vysoká váha znamená, že daný vstup má na výsledok veľký vplyv, nízka alebo nulová váha znamená, že je takmer irelevantný. Váhy sa počas trénovania postupne upravujú tak, aby čo najlepšie odrážali dôležitosť jednotlivých vstupov.
K súčtu vážených vstupov sa pripočíta bias, teda hodnota, ktorá posúva prah aktivácie. Vďaka biasu sa môže neurón aktivovať aj vtedy, keď sú všetky vstupy nulové, alebo naopak potrebuje silnejší signál, než by inak stačil. Bias tak dáva sieti dodatočnú flexibilitu, ktorú by samotné váhy nedokázali zabezpečiť.
Posledným krokom je aktivačná funkcia. Bez nej by celá sieť pri akomkoľvek počte vrstiev dokázala modelovať len lineárne vzťahy, čo by výrazne obmedzilo, čo sa dokáže naučiť. Aktivačná funkcia do výpočtu vnáša nelinearitu, vďaka ktorej sieť zachytí aj komplexnejšie vzory, napríklad hranice medzi kategóriami, ktoré sa nedajú opísať priamkou.
ReLU a cesta k dnešným hlbokým sieťam
Jednou z najpoužívanejších aktivačných funkcií je ReLU (Rectified Linear Unit). Ak je výsledný súčet záporný, neurón vráti nulu, ak je kladný, pošle hodnotu ďalej bez zmeny. Toto jednoduché pravidlo sa v praxi ukázalo ako prekvapivo účinné a výpočtovo nenáročné, preto dnes patrí medzi štandardné voľby pri návrhu neurónových sietí.
Predchodcom dnešných sietí bol perceptrón, jeden z prvých modelov neurónu, ktorý sa dokázal učiť z dát, no vedel riešiť len najjednoduchšie, lineárne oddeliteľné úlohy. Dnešné neurónové siete stavajú na rovnakom základnom princípe, len ho kombinujú vo výrazne väčšom rozsahu a s podstatne sofistikovanejšími aktivačnými funkciami.
Praktickému nasadeniu hlbokých sietí dlhé roky bránil takzvaný problém miznúceho gradientu: pri väčšom počte vrstiev sa signál chyby počas backpropagation (spätného šírenia chyby) postupne oslaboval, až sa prvé vrstvy siete prakticky prestali učiť. Hlboké siete preto dlho ostávali skôr teoretickým konceptom než praktickým nástrojom. Kombinácia lepších aktivačných funkcií, ako je ReLU, výkonnejšieho hardvéru a väčšieho množstva dát tento problém výrazne zmiernila a otvorila cestu k modelom s desiatkami až stovkami vrstiev.
… prvý umelý neurón, model McCullocha a Pittsa, vznikol už v roku 1943, no deep learning sa stal prakticky využiteľným až v roku 2012, keď konvolučná sieť AlexNet vyhrala súťaž ImageNet s výrazným náskokom pred konkurenciou?
Od neurónu k vrstvám: prečo „hlboké“
Neurónová sieť skladá neuróny do vrstiev a práve počet skrytých vrstiev určuje, prečo sa technológia volá hlboké učenie.
Každá sieť má tri typy vrstiev. Vstupná vrstva prijíma surové dáta, napríklad hodnoty pixelov alebo čísla z tabuľky. Skryté vrstvy tvoria jadro siete – každá z nich extrahuje zložitejšie vzory než tá predchádzajúca a vrstva po vrstve postupujú od jednoduchých čŕt k abstraktnejším konceptom. Výstupná vrstva na konci vyprodukuje finálnu predikciu, napríklad pravdepodobnosť, že daný obrázok obsahuje psa.
Pri rozpoznávaní obrázkov to vyzerá napríklad takto: prvá vrstva rozpoznáva len hrany a kontrasty, druhá z nich poskladá jednoduché tvary, tretia rozpozná časti objektov, napríklad oko alebo ucho a posledné vrstvy z toho zložia celý objekt. Čím hlbšie do siete ideš, tým abstraktnejšie a komplexnejšie sú vzory, ktoré jednotlivé vrstvy reprezentujú.
Čím viac skrytých vrstiev sieť má, tým zložitejšie vzory dokáže zachytiť, a práve preto hovoríme o hlbokom učení. Slovo hlboké tu odkazuje na hĺbku architektúry, teda počet vrstiev, nie na to, že by sieť rozumela veciam hlbšie ako človek. Dnešné siete môžu mať desiatky až stovky vrstiev, čo im umožňuje riešiť úlohy, na ktoré by plytšie architektúry nestačili.
Ako sa sieť učí: backpropagation bez vzorcov
Sieť sa učí opakovaním cyklu: predikcia, výpočet chyby, spätné šírenie chyby a úprava váh. Celý proces má štyri fázy:
- Dopredný priechod: vstupné dáta prejdú sieťou od vstupnej vrstvy až po výstupnú a vznikne predikcia.
- Výpočet chyby: predikcia sa porovná so skutočným, správnym výsledkom pomocou chybovej (stratovej) funkcie, ktorá vyčísli, ako veľmi sa sieť pomýlila.
- Backpropagation, teda spätné šírenie chyby: chyba sa pošle späť cez sieť a každý neurón dostane informáciu o tom, akou mierou k celkovej chybe prispel. Sieť tak vie presne určiť, ktoré váhy treba upraviť a akým smerom, namiesto toho, aby menila všetky váhy naslepo.
- Úprava váh: o veľkosti krokov rozhoduje parameter learning rate. Ak je príliš veľký, sieť preskakuje okolo správneho riešenia a nedokáže sa ustáliť. Ak je príliš malý, učenie je zbytočne pomalé, prípadne sa zastaví v suboptimálnom riešení.
Tento cyklus sa opakuje tisíckrát až miliónkrát a sieť pri každom prechode o niečo zlepší svoje váhy. Jeden úplný prechod cez celý trénovací dataset sa nazýva epocha, veľké modely sa zvyčajne trénujú desiatky až stovky epôch. Preto je trénovanie hlbokých sietí výpočtovo náročné a vyžaduje výkonný hardvér: čím viac dát, vrstiev a epôch, tým viac výpočtov treba na to, aby sa chyba postupne minimalizovala.
Samotnú úpravu váh riadi takzvaný optimalizátor, algoritmus, ktorý na základe vypočítaného gradientu chyby rozhodne, ako presne sa majú jednotlivé váhy zmeniť. Najjednoduchším prístupom je gradient descent, v praxi sa však častejšie používajú jeho vylepšené varianty, napríklad Adam alebo RMSprop, ktoré sa k optimálnemu riešeniu priblížia rýchlejšie a stabilnejšie aj pri veľkých sieťach s miliónmi parametrov.
Typy neurónových sietí
Základná architektúra neurónových sietí sa dá usporiadať rôznymi spôsobmi: výber závisí od typu dát a úlohy, ktorú má sieť riešiť. Medzi hlavné typy patria FNN, CNN, RNN a Transformer, každý optimalizovaný pre iný druh vstupných dát.
| Typ | Čo robí | Príklad použitia |
|---|---|---|
| FNN | Jednosmerný tok dát, žiadna pamäť | Základná klasifikácia, regresia |
| CNN | Filtre extrahujú priestorové vzory | Rozpoznávanie obrázkov a tvárí |
| RNN | Spracúva sekvencie, krátkodobá pamäť | Predikcia textu, časové rady |
| Transformer | Self-attention, celá sekvencia naraz | Veľké jazykové modely (GPT, BERT) |
FNN: jednosmerný tok dát
Feedforward Neural Networks (FNN) sú najjednoduchším typom siete: dáta v nich prúdia jedným smerom, od vstupu k výstupu, bez slučiek a spätných väzieb. Sú vhodné pre štruktúrované, tabuľkové dáta a používajú sa najmä pri regresii alebo základnej klasifikácii, kde netreba pamätať si kontext z predchádzajúcich vstupov.
CNN: obrázky a priestorové dáta
Convolutional Neural Networks (CNN) sú navrhnuté na spracovanie priestorových dát, predovšetkým obrázkov. Namiesto toho, aby spracúvali každý pixel samostatne, používajú filtre (konvolučné jadrá), ktoré prechádzajú po vstupe a extrahujú lokálne vzory: hrany, textúry, tvary. To zároveň výrazne znižuje počet parametrov v porovnaní s FNN, ktoré by museli spracovať každý pixel ako samostatný vstup. CNN sa tak stali štandardom pri rozpoznávaní tvárí, objektov aj v medicínskej diagnostike, kde treba identifikovať jemné vizuálne detaily.
RNN: sekvencie a časové rady
Recurrent Neural Networks (RNN) sú určené na sekvenčné dáta, teda dáta, pri ktorých záleží na poradí: text, reč, časové rady. Na rozdiel od FNN si RNN pamätajú informácie z predchádzajúcich krokov pomocou krátkodobej pamäte, čo im umožňuje pracovať s kontextom predošlých vstupov. Pri dlhších sekvenciách však táto pamäť rýchlo slabne. Riešením sa stali architektúry ako LSTM (Long Short-Term Memory), ktoré si dokážu udržať relevantné informácie na dlhšie obdobie.
Práve RNN architecture a modely typu deep recurrent neural networks, teda rekurentné siete s viacerými vrstvami nad sebou, stáli pri zrode dnešného spracovania textu a reči, ešte pred príchodom Transformerov.
Transformer: celá sekvencia naraz
Transformer je najmladší z tejto štvorice a dnes najvplyvnejší typ architektúry. Namiesto postupného spracovania jedného prvku za druhým spracúva celú sekvenciu naraz vďaka mechanizmu self-attention: sieť si sama vyhodnotí, ktoré časti vstupu sú pre danú úlohu najdôležitejšie, nezávisle od ich pozície v texte. Lepšie tak zachytí súvislosti aj na veľkú vzdialenosť v texte. Transformer architektúru predstavila v roku 2017 práca Attention Is All You Need a dnes je základom veľkých jazykových modelov (LLM), ako GPT, BERT alebo Gemini.
Hlavnou výhodou Transformerov oproti starším RNN je paralelné spracovanie. Kým RNN musí sekvenciu spracovať postupne, Transformer vyhodnotí všetky časti vstupu naraz. To výrazne skracuje čas tréningu na výkonnom hardvéri a umožňuje trénovať modely na oveľa väčších objemoch dát, než aké by boli s RNN reálne zvládnuteľné. Preto dnes Transformer pri spracovaní jazyka takmer úplne nahradil RNN, hoci tie si stále držia miesto pri niektorých typoch časových radov.
… architektúra Transformer z roku 2017, základ GPT, BERT a ďalších modelov, je dnes de facto štandardom pri spracovaní jazyka, obrázkov aj audia a stojí za väčšinou generatívnych AI nástrojov?
Deep learning vs machine learning: kedy čo použiť
Machine learning a deep learning nie sú to isté – deep learning je podmnožina strojového učenia, ktorá exceluje pri veľkých dátach, ale nie je vždy lepšou voľbou.
Pod strojové učenie deep learning síce patrí, no nie každý algoritmus strojového učenia je zároveň deep learning. Klasické metódy, napríklad rozhodovacie stromy, náhodné lesy, regresia alebo podporné vektorové stroje, fungujú na iných princípoch, nevyžadujú neurónové siete ani rozsiahle výpočtové zdroje a v mnohých situáciách sú stále lepšou, rýchlejšou a lacnejšou voľbou. Otázka preto neznie, ktorý z prístupov je „lepší“ všeobecne, ale ktorý sa hodí na konkrétny problém, dáta a rozpočet.
Ktorý prístup zvoliť, závisí od veľkosti dostupných dát, potreby vysvetliteľnosti výsledku, dostupného hardvéru aj typu úlohy, ktorú riešiš. Firmy, ktoré tento výber podcenia, často skončia s výrazne drahším a pomalším riešením, než aké potrebujú: nasadia napríklad komplexnú neurónovú sieť tam, kde by rovnako presné výsledky priniesol jednoduchší a lacnejší model. Hlavné rozdiely medzi oboma prístupmi zhŕňa tabuľka podľa piatich kritérií.
| Kritérium | Machine learning (klasické) | Deep learning |
|---|---|---|
| Veľkosť dát | Funguje aj na malých dátach (stovky až tisíce vzoriek) | Potrebuje veľké dáta (desaťtisíce a viac vzoriek) |
| Interpretovateľnosť | Vyššia, rozhodnutie sa dá vysvetliť | Nižšia („black box“), ťažšie zdôvodniteľné |
| Hardvér | Beží na bežnom CPU | Potrebuje GPU/TPU (alebo cloud) |
| Čas a náročnosť tréningu | Rýchlejší, lacnejší | Pomalší, výpočtovo náročnejší |
| Typický use case | Tabuľkové dáta, predikcia rizika, spam filter | Obrázky, jazyk, reč, autonómne riadenie |
Ak teda pracuješ s obmedzeným množstvom dát alebo potrebuješ presne zdôvodniť, prečo model urobil dané rozhodnutie, napríklad pri hodnotení rizika v poisťovníctve, klasické strojové učenie môže byť lepšou a lacnejšou voľbou. Ak máš naopak k dispozícii veľké množstvo dát a úloha si vyžaduje spracovanie obrázkov, reči alebo prirodzeného jazyka, deep learning ponúka výrazne vyššiu presnosť aj napriek vyšším nákladom na hardvér a dáta.
Deep learning v praxi
Využitie deep learningu dnes siaha od odporúčacích systémov v streamovacích službách až po autonómne vozidlá a medicínsku diagnostiku. Kým kedysi bolo jeho nasadenie doménou hŕstky veľkých technologických firiem s vlastným výskumným tímom, dnes vďaka cloudovým službám a predtrénovaným modelom siahajú po tejto technológii aj stredne veľké firmy naprieč odvetviami.
Počítačové videnie
Počítačové videnie patrí medzi najviditeľnejšie aplikácie deep learningu. Využíva ho napríklad Google Photos alebo Apple Face ID na rozpoznávanie tvárí. Nájdeš ho aj v monitorovacích systémoch, na sociálnych sieťach pri automatickej kategorizácii fotiek či v priemyselnej kontrole kvality, kde kamery s CNN modelmi odhaľujú chyby na výrobnej linke rýchlejšie než ľudské oko.
Spracovanie prirodzeného jazyka
Spracovanie prirodzeného jazyka stojí za nástrojmi ako Google Translate, DeepL alebo ChatGPT. Deep learning sa tu využíva aj na analýzu sentimentu, teda vyhodnocovanie nálady v textoch na sociálnych sieťach či v zákazníckych recenziách, čo firmám pomáha rýchlejšie reagovať na spätnú väzbu. Slúži tiež na automatickú kategorizáciu a smerovanie zákazníckych požiadaviek v podporných tímoch.
Na deep learningu stoja aj AI agenti, ktorí autonómne plánujú a vykonávajú úlohy, od jednoduchých asistentov až po zložitejšie automatizované workflow naprieč viacerými systémami.
Odporúčacie systémy
Odporúčacie systémy patria medzi komerčne najúspešnejšie využitia deep learningu. Netflix pomocou tejto technológie odporúča filmy a seriály podľa toho, čo máš pozreté, Amazon odporúča produkty na základe histórie nákupov a prezeraného obsahu. Podobný princíp stojí aj za personalizovanými playlistmi v hudobných službách.
Medicína a diagnostika
V medicíne sa deep learning osvedčil pri analýze röntgenových a MRI snímok, predikcii genetických ochorení či identifikácii nádorov, pri niektorých úlohách s presnosťou porovnateľnou s lekárskym hodnotením. Slúži najmä ako podporný nástroj, ktorý zrýchľuje prvotné vyhodnotenie snímok pred finálnym lekárskym rozhodnutím.
Deep learning v poisťovníctve
Deep learning poisťovníctvo mení najmä pri likvidácii poistných udalostí, odhaľovaní podvodov a oceňovaní rizika. Pri automatizovanom vyhodnocovaní poistných udalostí model analyzuje napríklad fotografie poškodenia vozidla po nehode a rozsah škody odhadne rýchlejšie než manuálne posúdenie. Pri detekcii poistných podvodov modely vyhľadávajú neobvyklé vzory v správaní alebo v predkladaných dokumentoch a pri personalizácii poistných produktov vychádzajú z rizikového profilu.
Presnejšie odhady rizika zároveň umožňujú poisťovniam nastaviť spravodlivejšie ceny poistenia a jednoduché škodové udalosti vybaviť bez čakania na manuálne posúdenie. Poistné plnenie tak môže byť pri jednoduchších škodách vyplatené v priebehu hodín namiesto dní či týždňov. Ako poisťovne pracujú s umelou inteligenciou v širšom zábere, rozoberá náš článok AI v poisťovníctve.
Výhody a nevýhody deep learningu
Deep learning dosahuje vysokú presnosť pri obrázkoch, reči a jazyku, platí sa za ňu však veľkým objemom dát, drahším hardvérom a nižšou vysvetliteľnosťou. Pri rozhodovaní o nasadení treba zohľadniť obe strany.
Medzi hlavné výhody patrí:
- vysoká presnosť pri komplexných úlohách, ako sú obrázky, reč alebo jazyk, kde klasické metódy zaostávajú,
- schopnosť spracovať obrovské množstvo dát bez manuálneho vyberania čŕt a definovania pravidiel,
- široká použiteľnosť naprieč odvetviami od zdravotníctva cez financie až po poisťovníctvo,
- automatizácia opakujúcich sa úloh, ktorá šetrí čas a znižuje chybovosť aj prevádzkové náklady.
Medzi hlavné nevýhody patrí:
- potreba veľkého objemu kvalitných, dobre označených trénovacích dát,
- nižšia interpretovateľnosť výsledkov, teda takzvaný black box efekt,
- náročnejší a časovo aj finančne nákladnejší tréning v porovnaní s klasickými metódami,
- potreba špecializovaného a drahšieho hardvéru, ako sú výkonné GPU alebo TPU.
Pri klasickom strojovom učení dokážeš relatívne ľahko vysvetliť, prečo model urobil dané rozhodnutie, pri deep learningu je to výrazne zložitejšie. Preto sa v citlivých oblastiach, ako je schvaľovanie poistných nárokov alebo úverov, kombinuje s ďalšími kontrolnými mechanizmami a ľudským dohľadom.
Mýty o deep learningu: 5 najčastejších
Deep learning je napriek svojej popularite oblasťou, o ktorej koluje viacero presvedčení, a to aj medzi ľuďmi z IT, ktorí sa mu priamo nevenujú. Znejú logicky, no nie sú pravdivé a môžu viesť k zlým rozhodnutiam pri výbere technológie pre konkrétny projekt. Toto je päť mýtov, s ktorými sa v praxi stretávame najčastejšie.
Mýtus č. 1: Deep learning je to isté ako umelá inteligencia
Fakt: Deep learning je len jeden z nástrojov umelej inteligencie, nie celá táto oblasť. Mýtus vznikol nesprávnym používaním pojmu umelá inteligencia, ktorým sa v bežnej reči označuje čokoľvek súvisiace s chatbotmi či neurónovými sieťami. V skutočnosti je AI nadradenou kategóriou, do ktorej patrí machine learning a v rámci neho aj deep learning ako jeden z mnohých prístupov.
Mýtus č. 2: Hlboké učenie je zázračná technológia
Fakt: Deep learning je účinný, no má svoje limity: bez dostatku kvalitných dát je nepoužiteľný, tréning je náročný na čas aj hardvér a nejde o univerzálny nástroj na akýkoľvek problém. Na mnohé úlohy, najmä pri menšom objeme dát alebo potrebe rýchleho nasadenia, je stále vhodnejšie klasické strojové učenie.
Mýtus č. 3: Deep learning dokáže vyriešiť každý problém
Fakt: Pri malých alebo jednoducho interpretovateľných dátach je deep learning často zbytočne komplikovaný, pomalý a drahý na prevádzku. Klasické metódy strojového učenia tu poskytnú presnejšie, rýchlejšie a lacnejšie výsledky bez špeciálneho hardvéru či rozsiahlej dátovej pipeline.
Mýtus č. 4: Deep learning je príliš drahý na bežné použitie
Fakt: Výkonné GPU si dnes vieš prenajať v cloude bez vlastného hardvéru a frameworky ako PyTorch alebo TensorFlow sú zadarmo a otvorené. Na začiatok môžeš využiť aj bezplatné cloudové kredity, verejne dostupné datasety, napríklad z Kaggle, alebo predtrénované modely, ktoré si len doladíš na vlastné dáta.
Mýtus č. 5: Deep learning je príliš náročné naučiť sa
Fakt: Ak máš skúsenosti so strojovým učením, deep learning ti nebude robiť zásadný problém, keďže vychádza z podobných matematických princípov. Aj bez predchádzajúcich skúseností sa ho pri kvalitných zdrojoch, mentoringu a trpezlivosti dokážeš naučiť. Dôležitejšia než genialita je systematickosť a prax.

Vlastný deep learning projekt začni na existujúcich frameworkoch, napríklad PyTorch alebo TensorFlow. Implementovať neurónovú sieť od nuly má zmysel ako študijné cvičenie, no v produkčnom prostredí tieto knižnice šetria mesiace práce a poskytujú optimalizácie, ktoré ručne dosiahneš len ťažko. Oplatí sa siahnuť aj po predtrénovaných modeloch: namiesto trénovania od nuly ich stačí doladiť na vlastné dáta, čím ušetríš čas aj výpočtový výkon.
FAQ: Často kladené otázky o deep learningu
Čo je deep learning?
Deep learning (hlboké učenie) je podoblasť strojového učenia, v ktorej sa viacvrstvové neurónové siete učia vzory priamo z veľkého množstva dát. Patrí pod strojové učenie a to zasa pod umelú inteligenciu. Prívlastok hlboké odkazuje na počet vrstiev siete. Od klasického machine learningu sa líši tým, že si vzory nachádza sám, bez ručne definovaných čŕt. Príkladom je rozpoznávanie objektov na fotografii alebo predikcia ďalšieho slova vo vete.
Aký je rozdiel medzi deep learningom a machine learningom?
Deep learning je podmnožina machine learningu – oba patria pod umelú inteligenciu, deep learning však potrebuje výrazne viac dát. Výmenou za to si vzory z dát extrahuje automaticky. Ak máš málo dát alebo potrebuješ jasne vysvetliteľný výsledok, napríklad pri regulovaných rozhodnutiach, zvyčajne stačí klasický machine learning, ktorý je lacnejší na tréning aj prevádzku. Pri obrázkoch, reči alebo texte vo veľkom objeme prináša deep learning vyššiu presnosť za cenu vyšších nárokov na dáta, čas a výpočtový výkon.
Čo sú neurónové siete?
Neurónová sieť je matematický model inšpirovaný mozgom: vrstvy neurónov transformujú vstupné dáta na výstupné predikcie. Medzi hlavné typy patria FNN, CNN, RNN a Transformer, každý optimalizovaný pre iný typ dát. Podrobné vysvetlenie s príkladmi nájdeš vyššie v časti Typy neurónových sietí.
Kde sa deep learning využíva v praxi?
Deep learning je dnes jadrom väčšiny AI systémov, od chatbotov po autonómne vozidlá a medicínsku diagnostiku. Využíva sa aj pri rozpoznávaní tvárí, v odporúčacích systémoch, pri spracovaní jazyka, v priemyselnej kontrole kvality či v poisťovníctve, napríklad pri vyhodnocovaní poistných udalostí a detekcii podvodov. Spoločným menovateľom je vždy veľký objem dát, z ktorých sa sieť môže učiť.
Je deep learning drahý?
Deep learning už nemusí byť drahý. GPU výpočty sú cez cloud dostupné za desiatky eur mesačne a frameworky ako PyTorch či TensorFlow sú zadarmo. Kedysi bol výsadou veľkých firiem s vlastným dátovým centrom. K dispozícii sú aj bezplatné verejné datasety, napríklad na Kaggle, takže vstupné náklady sú výrazne nižšie než v minulosti. Investovať budeš najmä čas, znalosti a kvalitné dáta, nie nutne veľký počiatočný rozpočet.
Je ChatGPT deep learning?
Áno, ChatGPT je postavený na deep learningu, konkrétne na Transformer architektúre, ktorá patrí medzi najpokročilejšie typy neurónových sietí. Na obrovskom množstve textov sa naučil predpovedať ďalšie slovo. Deep learning je teda technológia a ChatGPT jeden z produktov, ktoré na nej stoja, rovnako ako Gemini alebo iné veľké jazykové modely (LLM).
Zhrnutie: čo si z deep learningu odniesť
Deep learning nie je zázračná ani nebezpečná technológia. Je to nástroj, ktorý pri správnom použití zvládne spracovanie obrazu, jazyka aj podporu rozhodovania naprieč odvetviami. Podstatné je vedieť, kedy po ňom siahnuť a kedy plne postačí klasické strojové učenie.
Z článku si odnes tri veci: ako funguje neurónová sieť od jednotlivého neurónu až po celú architektúru, v čom sa deep learning líši od machine learningu a kde sa dnes reálne využíva, vrátane poisťovníctva. Pri praktickom nasadení býva otázka, či sa hlboké učenie na daný problém vôbec oplatí, dôležitejšia než samotná znalosť architektúr.
Ak ťa táto oblasť zaujala, pokračuj článkom o tom, ako funguje generatívna umelá inteligencia, ktorá na deep learningu stojí. A ak ťa baví, ako technológie menia prácu s dátami, pozri si, na čom pracujeme v msg life Slovakia, a aktuálne voľné pozície.
Zdroje:
- https://www.nature.com/articles/nature14539
- https://arxiv.org/abs/1706.03762
- https://www.ibm.com/think/topics/deep-learning
- https://www.geeksforgeeks.org/deep-learning/introduction-deep-learning/
- https://cloud.google.com/discover/what-is-deep-learning
- https://www.databricks.com/blog/what-is-deep-learning
- https://developers.google.com/machine-learning/crash-course
- https://docs.pytorch.org/docs/stable/index.html
- https://www.tensorflow.org/learn


- Generácie X, Y, Z a baby boomers na pracovisku: Ako s nimi pracovať?
- Ako napísať jednoduchý motivačný list do zamestnania + VZOR motivačného listu
- Žiadosť o prijatie do zamestnania: Vzor a ako ju napísať
- Šikana na pracovisku: bossing, mobbing. Ako proti nim bojovať?
- Otázky na pohovore pre budúceho zamestnanca aj zamestnávateľa s odpoveďami
- IT novinky zo sveta technológií


